
採掘中にseineのCPUスレッド数が変わる理由を理解しましょう。このガイドは公開版v0.2.36に基づき、採掘を伴う調整、保存設定、メモリ対応を説明します。導入は採掘ガイド、各表示の意味はダッシュボード解説をご覧ください。
CPUの自動調整はどう動きますか?
CPU調整が有効なら、seineは互換性のある保存スレッド数かハードウェアに基づく推定値で採掘を始め、実際の採掘作業で設定を比較します。基準値、候補、再び基準値の順に測定します。利用可能なRAMと設定された範囲の中で、その機械に適した設定を探します。
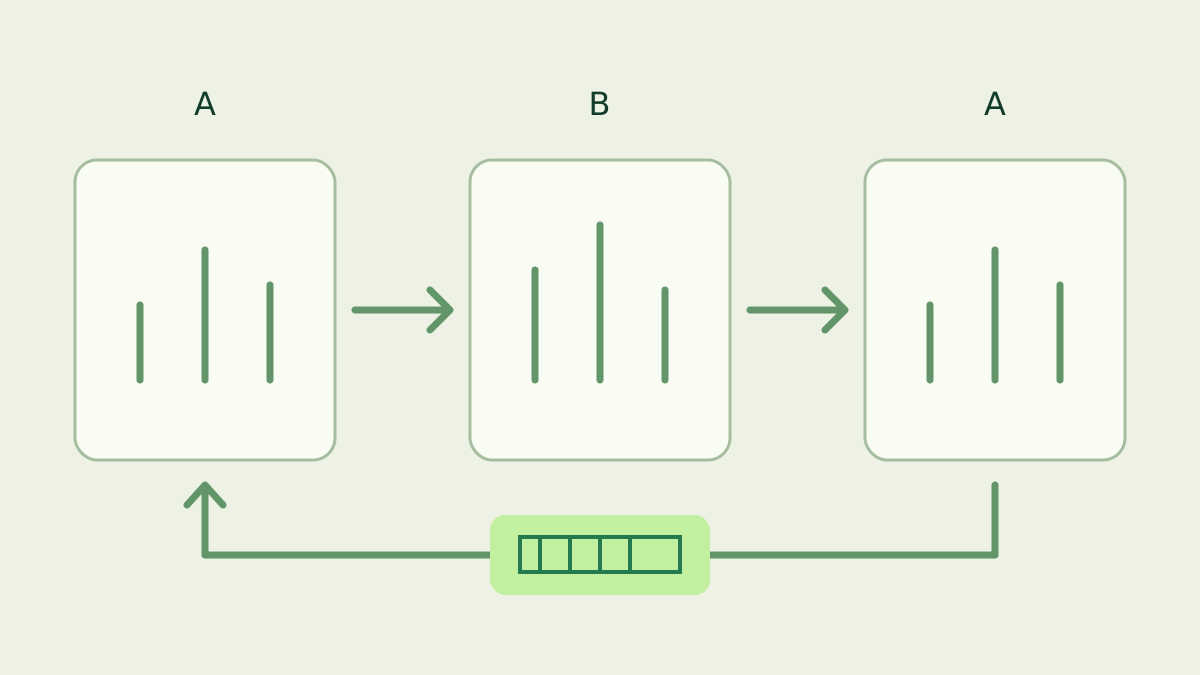
探索が終わる前に採掘は始まります
自動スレッド調整には--threadsを指定しません。通常採掘では現在の資源枠内で初期数を選び、オフラインで全スレッド数を試すことなく有効な仕事を始めます。互換キャッシュがあれば開始点に使います。新しい機械では推定値から始め、その後の比較で選択を改善します。
各試験は経過時間あたりの完了ハッシュを測ります。新しいメモリアリーナは最初のハッシュを終えてから測定区間に入ります。基準・候補・基準の順序は設定の効果と環境変化を区別するためです。基準の大きな変動、メモリ上限の変更、継続的な仕事の喪失があると比較を破棄できます。表示の一時的な急上昇は長い判断過程の一観測にすぎません。
スレッドを増やしても速くならないのはなぜですか?
各CPUスレッドは大きなメモリアリーナを使い、機械のメモリ帯域を共有します。スレッド追加で並行作業は増えますが、成果はシステム全体次第です。調整機構は最大数が最速と決めつけず、CPU全体のH/sを比較します。メモリ枠はRAMガイドで説明しています。
既定プロファイルはbalancedです。プロファイルは調整方針と実行時の既定値を制御し、efficiencyは少ないスレッドを選ぶ場合がある明示的な選択肢です。評価中は同じプロファイルを使いましょう。スレッド数、CPU配置、メモリページの種類は相互に影響するため、別の機械の結果は参考であり、そのままコピーする設定ではありません。
ほかのアプリがRAMを必要とするとどうなりますか?
自動メモリ枠は利用可能な資源に応じて変わります。メモリが逼迫すると、CPUスレッドは現在のハッシュを終え、休止してアリーナを解放できます。余裕が継続して戻れば、空きスロットを有効化して探索を再開できます。ほかのアプリも動かす機械では、同じセッション中に稼働数を状況へ合わせられます。
一時的に減らしても、以前学習した多いスレッド数を消す必要はありません。キャッシュと稼働数は目的が異なります。Linuxで明示的HugeTLBアリーナを解放すると、予約済みhuge pageプールへ戻ります。seineはOS側プールのサイズを変更しません。予約の変更はhuge pagesガイドを参照し、通常の空きRAMと区別してください。
CPUカーネルも調整しますか?
対応CPUではスレッド数に加え、対応するハッシュ計算コード経路を比較できます。ここでカーネルとはハッシュ計算のソフトウェア実装です。CPU命令の対応を確認し、実採掘の反復サンプルで候補を比べます。カーネルとスレッド数の試験は交互に行い、メモリ管理は継続します。リリースの候補経路は技術ガイドにあります。
自動CPU変更はプール接続を維持し、GPUバックエンドを再起動しません。カーネルはハッシュ完了の間で切り替え、確保済みアリーナを保持します。一方、ダッシュボードで手動の+や-を押すと採掘バックエンドを再起動し、プールへ再接続し、その実行中のCPU自動調整を無効にします。どちらの変更かはログで確認できます。
保存した調整結果はどう再利用しますか?
スレッドキャッシュの既定名は--data-dir内のseine.cpu-autotune.json、カーネル用はseine.cpu-autotune.json.kernels.jsonです。プール接続設定とは別に学習結果を保存します。起動ごとに同じデータディレクトリを使ってください。アプリ交換時の保持方法は更新ガイドで説明しています。
再利用にはハードウェアやビルドの識別情報、配置、ページ設定などの互換性が必要です。開始時の稼働数は現在の資源上限にも制約されます。重要な設定変更後にキャッシュが使われないのは想定内です。適切な測定を再収集させ、他機のキャッシュをコピーしたり測定値を手編集したりしないでください。探索の再開を問題と判断する前に起動・調整ログを読みましょう。
スレッド数を固定するのはいつですか?
再現可能な構成が明確に必要なときは固定数を使います。たとえば--threads 4は4スレッドを要求し、通常はスレッドとカーネルの自動調整を無効にします。--cpu-autotune-threadsは数を指定していても調整を明示的に有効化し、--disable-cpu-autotune-threadsは自動調整を無効にします。探索範囲と組み合わせはフラグ一覧を参照してください。
日常の採掘では既定値から始め、比較が終わる時間を与えましょう。CPU行、調整メッセージ、受理シェアを合わせて確認し、似た負荷とメモリ条件で比較します。プールのハッシュレートは到着シェアからの推定です。試験の理解にはマイナーのCPU測定を、計上された活動にはプール統計を使ってください。
よくある質問
CPUスレッドの調整中も採掘しますか?
はい。v0.2.36の通常採掘は互換性のある保存設定またはハードウェアに基づく推定値から始まり、実際の採掘作業でスレッド数を比較します。オフラインベンチマークには別の調整処理があるため、その起動順序を通常の採掘に当てはめないでください。
CPUスレッド数が変わるのはなぜですか?
自動調整は近いスレッド数を試し、利用可能なメモリにも対応します。変更は性能試験の場合もRAM不足への対応の場合もあります。ログも確認し、短時間のハッシュレートだけで判断せず比較の完了を待ってください。
CPU調整の結果はどこに保存されますか?
既定ではデータディレクトリのseine.cpu-autotune.jsonです。カーネルの選択には末尾が.kernels.jsonの補助ファイルを使います。同じデータディレクトリを維持し、現在の環境との互換性をマイナーに確認させてください。